Lecture 01
人类学习:
机器学习:
机器学习目的:
unknown target function:
$$
f : \mathcal{X} \rightarrow \mathcal{Y}
$$
机器学习过程:
$$
\mathcal{A} \text { takes } \mathcal{D} \text { and } \mathcal{H} \text { to get } g
$$
$\mathcal{A}$ 是机器学习算法
$\mathcal{D}$ 是数据
$\mathcal{H}$ 是公式集合
$g$ $\approx f$ 的假设
Lecture 02
Vector Form of Perceptron Hyponthesis
$$
\begin{aligned} h(\boldsymbol{x}) &=\operatorname{sign}\left(\left(\sum_{i=1}^{d} w_{i} x_{i}\right)-\text { threshold }\right) \ &=\operatorname{sign}\left(\left(\sum_{i=1}^{d} w_{i} x_{i}\right)+\underbrace{(-\text { threshold })}{w{0}} \cdot \underbrace{(+1)}{x{0}}\right) \ &=\operatorname{sign}\left(\sum_{i=0}^{d} w_{i} x_{i}\right) \ &=\operatorname{sign}\left(\boldsymbol{w}^{T} \boldsymbol{x}\right) \end{aligned}
$$
Perceptrons in $\mathbb{R}^{2}$
$\boldsymbol{x}$: points on the plane( or points in $\mathbb{R}^{d}$), ${h}$: lines ( or hyperplanes in $\mathbb{R}^{d}$)
$$
h(\boldsymbol{x})=\operatorname{sign}\left(w_{0}+w_{1} x_{1}+w_{2} x_{2}\right)
$$
label $y$: +1 or -1
$$
\text { perceptrons } \Leftrightarrow \text { linear (binary) classifiers }
$$
Select ${g}$ from $\mathcal{H}$
- want: $g$ $\approx f$
- difficult: $\mathcal{H}$ is of infonite size
- idea: start from some $g_{0}$
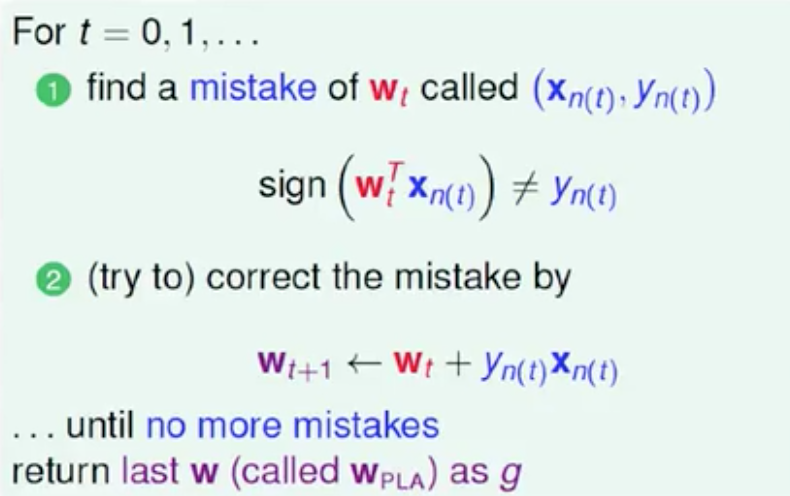
Perceptron Learning Algorithm
$$
\operatorname{sign}\left(\mathbf{w}{t}^{T} \boldsymbol{x}{n(t)}\right) \neq y_{n(t)}
$$
$$
\boldsymbol{w}{t+1} = \boldsymbol{w}{t}+y_{n(t)} \boldsymbol{x}_{n(t)}
$$
$$
- \text {A fault confessed is half redressed. :-) }
$$
Definition 1.1: $\boldsymbol{w}f$ satisfies $y{n}=\operatorname{sign}\left(\boldsymbol{w}{f}^{T} \boldsymbol{x}{n}\right)$
Then: $\boldsymbol{w}_t$ get more aligned with $\boldsymbol{w}_f$
(i)
$$
y_{n(t)} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n(t)} \geq \min {n} y{n} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n}>0
$$
$$
\begin{aligned} \boldsymbol{w}{f}^{T} \boldsymbol{w}{t+1} &=\boldsymbol{w}{f}^{T}\left(\boldsymbol{w}{t}+y_{n(t)} \boldsymbol{x}{n(t)}\right) \ & \geq \boldsymbol{w}{f}^{T} \boldsymbol{w}{t}+\min {n} y{n} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n} \ &>\boldsymbol{w}{f}^{T} \boldsymbol{w}_{t}+0 \end{aligned}
$$
(ii)
$$
\begin{array}{c}{\boldsymbol{w}t \text { changed only when mistake }} \ \Leftrightarrow \operatorname{sign}\left(\mathbf{w}{t}^{T} \boldsymbol{x}{n(t)}\right) \neq y{n(t)} \Leftrightarrow y_{n(t)} \boldsymbol{w}{t}^{T} \boldsymbol{x}{n(t)} \leq 0 \end{array}
$$
$$
\begin{aligned}\left|\boldsymbol{w}{t+1}\right|^{2} &=\left|\boldsymbol{w}{t}+y_{n(t)} \boldsymbol{x}{n(t)}\right|^{2} \ &=\left|\boldsymbol{w}{t}\right|^{2}+2 y_{n(t)} \boldsymbol{w}{t}^{T} \boldsymbol{x}{n(t)}+\left|y_{n(t)} \boldsymbol{x}{n(t)}\right|^{2} \ & \leq\left|\boldsymbol{w}{t}\right|^{2}+0+\left|y_{n(t)} \boldsymbol{x}{n(t)}\right|^{2} \ & \leq\left|\boldsymbol{w}{t}\right|^{2}+\max {n}\left|y{n} \boldsymbol{x}_{n}\right|^{2} \end{aligned}
$$
start from $\boldsymbol{w}_0 = \boldsymbol{0}$, after T mistake corrections,
$$
\begin{aligned} \frac{\boldsymbol{w}{f}^{T}}{\left|\boldsymbol{w}{f}\right|} \frac{\boldsymbol{w}{T}}{\left|\boldsymbol{w}{T}\right|} & \geq \frac{T \cdot \min {n} y{n} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n}}{\left|\boldsymbol{w}{f}\right| \left|\boldsymbol{w}{T}\right|} \ & \geq \frac{T \cdot \min {n} y{n} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n}}{\left|\boldsymbol{w}{f}\right| \cdot \sqrt{T} \cdot \max {n} \left|\boldsymbol{x}{n}\right|} \ & \geq \sqrt{T} \cdot \frac{\min {n} y{n} \boldsymbol{w}{f}^{T} \boldsymbol{x}{n}}{\left|\boldsymbol{w}{f}\right| \cdot \max {n} \left|\boldsymbol{x}{n}\right|} \ & \geq \sqrt{T} \cdot \text { constant } \end{aligned}
$$
Pros:
- simple to implement, fast, works in any dimension d
Cons:
- Assumes linear separable
- not fully sure how long halting takes
Learning with Noisy Data
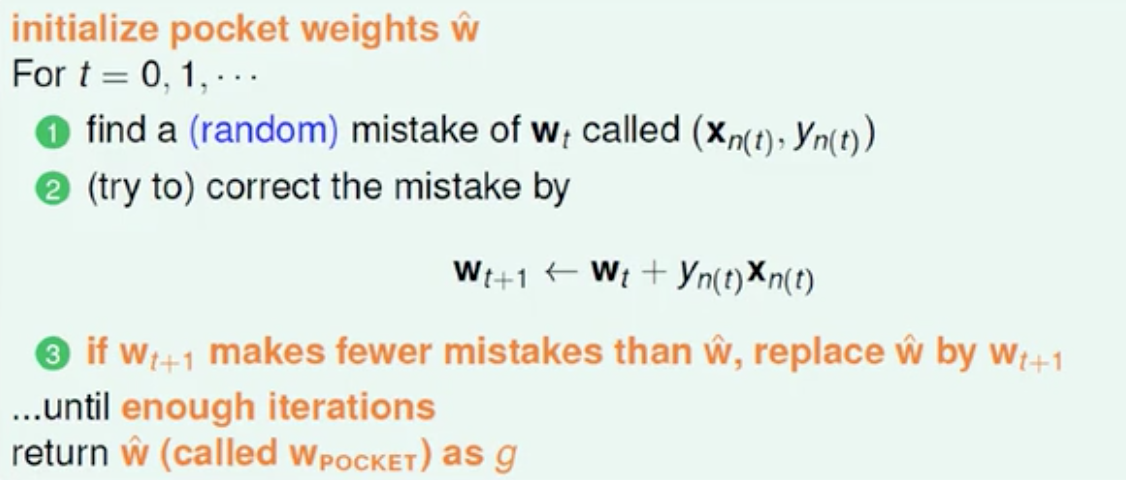
Pocket Algorithm